AIxOCR 文件辨識|紙本轉譯為可用資料
從 0 建立文件辨識平台,目前上線兩產品。 [ 憑證報銷 ] 服務多家企業,把紙本憑證轉譯為結構化資料、判斷會計科目、依規則審核,並自由匯出適配格式。 [ 處方箋比對 ] 服務大藥局,處方箋辨識後,與藥師系統資料批量比對,找出登打錯誤。 前者核心在於高彈性,讓一套系統通用到所有客戶。後者因格式明確,則在於比對規則與效率。
Year
2025.11 – 2026.03
Duration
4month
Client
10+企業, 2藥局
Role & Responsibility
產品規格|資訊架構|UXUI|文件樣本蒐集與標註|會計與處方箋領域知識建立|客戶端欄位對映前製|開發驗收測試
Category
AI, OCR
Result summary
憑證報銷解方上線後每月百件量級的市場詢問,
已導入客戶回報單據處理省下約一人 2~3 成工時。
同一套架構另延伸至嬰兒奶粉大廠之訂購單與多家工廠之手寫工單。
一個月平均吸引120-150個客戶洽詢,進入Demo約70%,Demo後簽約比例約15%
產品現以 Munger AI 文書自動化 AI 對外銷售:產品介紹網站
Background
初始起點來自Marco的手寫訂單辨識(說明在此)。
公司判斷「把紙本變成資料」的市場遠大於單一客戶,開始外接:
企業的憑證報銷、各式訂購單、製造業手寫工單、藥局處方箋…等多樣化辨識需求。
|客戶族群與主要痛點|
傳產為大宗,貿易或製造相關,以及藥局。這些產業有非常多紙本,報關單,訂貨單,出貨單,銷貨單,發票等等的。
|主要痛點|
花很多時間在處理例行事務,想找工具來節省時間與人力登打,報帳為最大宗
Statement of the Problem
初期製作的MVP(AI n8n協助)是像客戶證明我們的應用在憑證辨識的基本效用,但實際上無法真實「運用」:
1 因產出是純文字,缺資料結構,無法批量、有脈絡地存有
2 無法依照需求去動態匯出、排序、篩選。使用者找特定資料、特定格式匯出的頻率極高,理想資料出不來。
3 一次只服務一客戶。 每接一個新需求就要重跑一次流程。
4 客戶要的不只是辨識,還需知道這張能不能報、屬於哪個會計科目、如何匯入既有系統。而處方箋辨識完,需知道哪一筆跟系統紀錄對不上。
設計焦點因此為:
雖然判斷交由 AI 進行,但介面如何快速且易懂、可信可理解、可改動;
加上當同一套系統要服務性質格式不同的檔案資料,自由度的開放程度如何判斷。
Limitation
辨識錯誤率與成本皆高
憑證、工單、處方箋的版式非常多樣不一致
處方箋的錯誤直接關係到用藥紀錄的正確性
|AI 的辨識正確率一開始遠低於可用水準|
0 / O, 1 / l , G / B…等互相辨錯,或碼數少位數,
欄位定位錯置、繁體中文姓名經常出錯。
手寫字千奇百怪使辨識非常不易…等
|原始檔品質不可控|
憑證是手機拍且一張塞很多發票,
處方箋則是掃描,字糊、過黑、過淡、過小都大大影響結果。
客戶既有系統的格式、碼數、必填、特殊標示都不盡相同,需逐一統整、標註、找解方、訓練。
|效能與體驗互相牽制|
檔案如何預覽、資料存在哪、哪些走快取,很大影響系統量體。
設計上比較好用高效的做法,未必是能上線的做法。
|Domain knowledge 補救|
會計科目怎麼分、怎麼分憑證類型、處方箋上各個項目的各種簡寫是什麼意思,都要先自己搞懂與學習。
Part 1|憑證報銷— 高度彈性為目標
企業的單據版本類型量大難窮舉,各自的報帳規定、會計系統、要看的欄位都不同。
如果每個差異都靠我方開發解決,未來就會是:有報帳需求做一套系統、有工單需求做另一套、有處方箋再做第三套。
Key Decision
1 先建立資料骨架,後設計系統
一次上傳拆成上下兩層:上層上傳紀錄,每張憑證是一筆檔案紀錄。
接著為欄位定義必要的資料型別(文字、數值、日期、單多選、核取、關聯、貨幣、附件等),逐一定義各型別的顯示、操作與限制。
人員清單、會計科目、付款方式這些高變動資料,設為關聯資料表由客戶自行維護。
這一步畫面還不需要定型,因排序、篩選、匯出、規則插入值…,建立在「系統要知道這筆資料的型別」之上。
2 用試算表概念承載一份資料的多種用途
客戶不只需要一種視圖— 初步檢查、內部審核、會計師審核、匯出匯入到既有系統,欄位組成各不相同。
為每種用途個別做頁面太沒有效率,解方為讓客戶依動態需求自己設定表格,
決定個別要顯示哪些欄位、怎麼命名、排列與凍結。
「列」=每筆憑證,「欄」=屬性與值,操作模型借鑑 Lark 與 excel 試算表,讓使用者不需學新的心智模型,可以使用熟悉的試算表觀念來建立並沿用組織規定的表格。
篩選功能則依欄位型別動態變化,文字可用關鍵字、數值用大於/小於/範圍/指定、日期用區間/早於/晚於,每一種都要單獨定義,且PRD與設計稿需詳盡描述,著於開發與測試。
3 為 AI 的不確定性設計可見度
辨識一定有錯誤,重點在於怎麼告知使用者(甚至完全一致也需提醒注意)
使用三種設計來提示,讓使用者自行判斷(不該全依賴AI,保留修正機制與人的判斷權)
|信心度分級|
>0.85 不提示,0.70–0.85 在欄位右上用「黃色角標」表示建議確認,<0.70 用「紅色角標」表示務必檢查。(經驗來自 Marco OCR)
|區分空值的不同意義|
「非必填空值」與「必填空值」雖理論上都是空值,但重要性不一樣,後者需要提示檢查、補充。因此前者填入破折號(至少能被儲存),後者留白(必填留白無法被儲存)。
|修改資料的呈現與恢復|
手動修改的值會變色,Hover可看原始辨識值,可一鍵還原(讓錯誤操作有恢復路徑)
產品要點:標示出哪幾欄需要多看一眼,不是亮眼的功能,但應為 AI co-work重要基本機制。
4 產品亮點:規則審核
不是客戶提的需求,是我自己的提案—
資料一定要等到審核人去評估,不能在讓 AI 依照內部規則先審過一遍嗎?
一次轉向:
預想是讓 AI 辨識與合規判斷可以同時發生,工程師確認不行,必須先辨識、再拿結構化的資料做第二次判斷。架構會是兩條 pipeline。架構的限制不會反應在介面&體驗上,
使用者還是只有一次上傳,但秒數會增加10~20秒(後優化到僅多3~5秒)
二次轉向:
從「規則引擎」改為「自然語言」— 我原本設計了規則類型、優先序、處理強度與 20+條專屬報帳用規則。後發現針對欄位設條件不是 AI 的範疇,是系統在做運算,
且每多一個規則就要開發測試一次。後改為規則輸入框與簡單的設定,客戶可用自己的話描述規則。
讓自然語言可靠的關鍵是支援插入欄位變數,例如「當辨識到的 {{買方統編}} 不是 12348765,則標記不通過」。把不該讓 AI 自由發揮的部分框定明確的指涉資料。
規則另可指定適用的檔案類型(如統一發票、免用統一發票收據、車票、報關單…)。
成果與未解:
規則命中會顯示為什麼違反,這是 Demo 時唯一讓客戶有 Ah-ha moment 的部分。
但規則沒命中時,系統也不會說明,業務端因此不敢放在進一步的正式合約承諾。
若能重做,會保留人供設定的硬性檢核,處理統編格式/日期範圍這類有明確答案的判斷,把語意與多重判斷交給 AI。
5 產品邊界與自訂義的界線
為何不做一條龍會計系統:已有大量成熟的會計簽核系統,是為紅海不易競爭。
機會點是這些系統普遍老舊、難用、昂貴,客戶想換,只是沒有更好的入口時機。
因此產品定位先站在流程最前,讓客戶匯出能直接匯進文中等主流財會系統的 CSV。
自訂義開到多大,是過程中的最大難點。
一開始共識是盡量少開放,因每個可設定的地方都是開發成本;
越到後面越發現,寫死的部分就是為下一個客戶開發的重工根源。
提出「模組化」解方:
把「檔案辨識、工作流處理、格式匯出」想成四個可設定的事——
上傳表單、辨識後欄位、輸出格式、規則審核。
因此我設計了設定後台與操作介面,改過非常多版且難度高於預期,
主因為使用體驗都可以更直覺易懂,與開發難度之間的取捨。
(後因各個客戶的緊急需求而推後)
6 學習會計基礎知識
AI 自動分憑證類型、會計科目與規則審核。把關/訓練者學習基本相關知識是必要的。
蒐集分類各類憑證樣本,理解科目怎麼分、傳票怎麼建,才能有更精準的設計與測試。
前期花大量心力整理撰寫完整的範本、則說明與測試案例,提供工程師開發與QA來測試。
每個匯出模板配一份對映要匯入之系統設定檔。每個客戶的模板都要重調,逐一比對他們系統裡每個欄位的格式、碼數、必填與特殊標示,這些都由我整理交付。
是我投入最多、也最不像設計工作的部分,但也是最必要基本的。
Delivery
前台是手機優先的上傳WebApp,三步完成。
後台涵蓋上傳紀錄、辨識紀錄、辨識設定、檔案類型、關聯資料、審核規則。
辨識Pipeline 4階段:圖片前處理> 檔案類型判斷> 欄位辨識> 審核判斷。
前處理:判斷這張影像裡有幾張憑證,因為客戶習慣把好幾張發票攤在桌上拍成一張。
跨情境複用:「奶粉訂購單」沿用同一套系統,我整理出 14 種紙本格式讓 AI 分辨,
大量工作在建立對照表,如:業務與醫師手寫的「HA」是水解配方、「AL110」是無乳糖型號(不會是產品全名而是行內用簡寫)
另有3~5個客戶的手寫工單,以及進行中的護照與海關報關單。
在系統還沒被模組化前,因要快速上線的緣故,使用同一套架構撐過三種完全不同的文件。
設計決策 | 上線後的市場訊號 |
|---|---|
辨識結果的可信度呈現 | Demo 反應最正面的功能之一;「信心標記」後來成為官方頁三大亮點之一 |
自然語言審核規則 | 規則命中時是全場讚嘆點;官方以「可自定義 AI 審計規則」為主打 |
把檔案類型獨立成模組 | 驗收期最大爭議正是「實際單據遠超範本」;官方以「不再受限於固定版型」為賣點 |
表格模板可自訂欄位 | 客戶主動提出希望能自己在介面上自由調整、設定欄位 |
設計解決不了的部分
業務回饋:客戶的痛點不夠痛、導入門檻高、產品無法全面覆蓋客戶的問題,客戶乾脆沿用原流程。卡點集中在串接內部 ERP。
以上暫時非設計能解決的問題,當導入成本高於痛點強度,介面與體驗優化的邊際效益不高。
上線後迭代
手機上傳介面移植到後台也可操作
欄位可自訂排序
詳情快速切換上下筆且檔案預覽範圍更大
辨識紀錄補充上傳來源資訊
欄位雙名稱制(系統識別名&表格內自訂名稱)
Part 2|處方箋比對:收束彈性為目標
經過與藥師訪談,總結三類狀況:
人工登打處方箋已是習慣,但只能抓空檔或下班後做
有登打錯誤是很可能的
要再另外找時間把系統資料跟紙本核對一次
以上對應到本產品的三個部分:
辨識取代登打
比對取代人工核對
比對狀態呈現取代手動標記與整理
主要問題:既有的憑證產品在這裡用不了。
憑證報銷是由他人一次上傳幾張、累積多人多張後供人員一張張複查;
藥局是一天累積 200張左右的處方箋、下班前一次上傳。
加上憑證辨識完就能等待另一方審核,但處方箋辨識完還需要同組人去處理比對
且處方箋的複雜度遠高於憑證。
領域知識
處方箋的欄位有固定的專業結構,簡寫也有固定意義。同樣需要先理清,但若AI 辨錯了其嚴重性較高(醫療相關+量大+可能性太多+一對一),易造成藥師處理時更勞力耗時
欄位格式的變體必須事先窮舉(來自於詳細將上百張處方箋一一分類、標示需辨識的欄位)。困難點如:
身分證字號常以*遮蔽部分位數且遮法不固定數值寫法與字體多樣,大程度干擾辨識
就醫日期多為民國年,但台大、長庚、慈濟、彰基用西元年需能自動換算;姓名辨識正確率難以提升,是AI最容易有幻覺的地方調劑序號&可調劑次數最難辨識,要判斷「藥局印章蓋在表上哪一格」,也是AI最難判斷的
觀察與部分解方:
讓 AI 先判斷是「一般處方箋」還是「連續處方箋」(一張可多次拿藥),
一般處方箋的可調次數與調劑序號一定都是 1,諸如此類的前置判斷,替AI省掉部分難以辨識的瓶頸。
前置整理
小診所使用 3種公開格式,但大醫院各有自己的版式。
我整理與標記了20+種處方箋,每一種都要手動標示每個欄位在紙上的位置,
並記錄各家的特殊狀況;還也需整理代碼對照表:使用頻率有 36 種簡寫、給藥途徑與作用部位有40 種,再交給工程師訓練 AI,也撰寫測試準則讓之後的測試有指導依據。
這段雖然極為枯燥,但沒有這些後面什麼都做不準。
Key Decision
1 去識別化
醫療個資絕不能送雲端模型,必須先碼掉才能進入辨識。
這花了非常多時間,因 AI 很難穩定去識別化(尤其處方箋格式太多)
換一種格式就要重新不斷調校。
意外的結果是這個困難反過來強化了「檔案類型」模組的必要性:
如果每種格式都要單獨處理,格式就成了系統的魔王。
這個判斷後來回饋到報銷憑證產品線的架構上,
機制也被推廣解釋為「動態個資識別引擎」。
2 為批次節奏設計
藥局的節奏是一天一次、200 多張,上傳功能因此重做。
用上傳時間分組取代資料夾。 同一次上傳自成一組,組間插入標示列顯示時間。
省掉了整套資料夾功能,因心智模型是「今天下班前上傳今天這批」。
上傳時同步檢查格式與規定(支援性、大小、頁數、數量… )若等到辨識階段才發現不合格,等於整批要重傳。
與憑證報銷不同,篩選刻意寫死:因處方箋格式明確,少一層設定,就少一 part 讓藥師耗心耗時。
3 辨識詳情:左原檔右資料,用 bounding box 對位
抽屜左側是原始檔畫面,右側是格式化資料,可編輯也可增刪藥品。當焦點落在某欄位時,左側預覽圖會高亮該資料在原檔上的位置。
這是整個產品裡最具亮點的設計(來自Marco OCR之經驗)。
當懷疑某一格辨識錯了,不需要在整張圖中尋找,能直接看到「這一格從哪讀出來」。
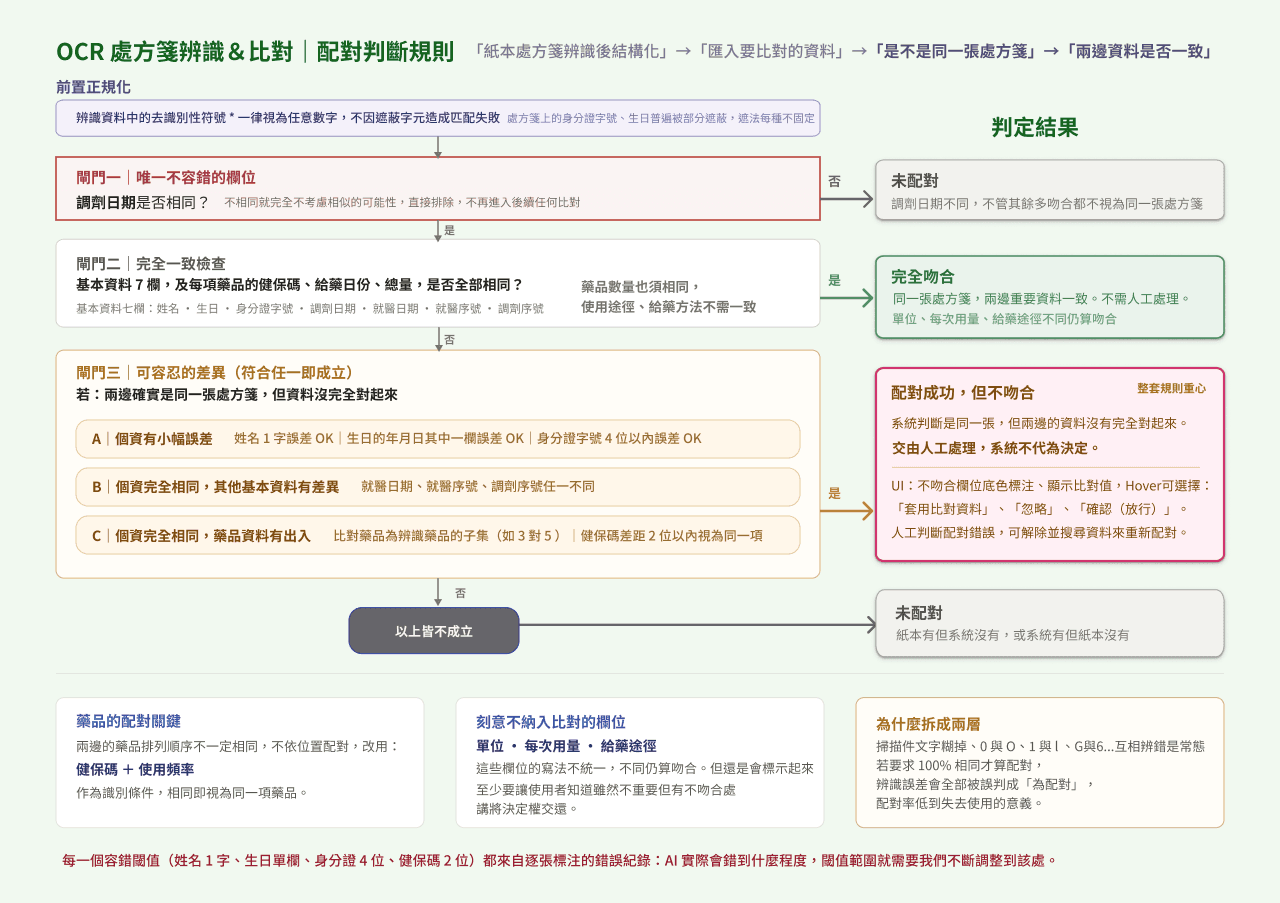
4 拆分「是否同一筆」與「資料是否一致」
直覺是把比對當成一次判斷:對得上=吻合,對不上=有問題,但這樣配對成功率極低。
掃描件字糊、過黑、過淡,把 0 讀成 O、1 讀成 l、碼數少一位、繁體姓名認錯,都很常見。要「全部相同」才算配對,等於完全拒絕了「有辨識誤差但不一定就是不同張」
因此拆成兩層:先確定兩筆是不是同一張處方箋,再判斷資料是否一致。
結果就會有三種:
|完全吻合|
基本資料 7 欄全部相同,藥品數量相同,且每項藥品的健保碼、給藥日份、總量都相同
藥品排列順序可能不同,所以配對「不看排序」,改用「健保碼+使用頻率」當識別關鍵
且辨識資料中的去識別碼:* 視為任意數字。單位、每次用量、給藥途徑不納入比對,不同仍算吻合,但還是會用藍色來標示有差異。
|不吻合|(配對成功)
判定是同張處方箋,但資料沒有全對起來,需要人力確定。
硬性前提是調劑日期必須相同。在此下「容錯閾值」符合任一即成立配對—
個資有小幅誤差(姓名 1 字、生日年月日其中一欄、身分證字號 4 位內);
個資相同但就醫日期、調劑序號有差異;
個資相同但藥品有出入(比對方為辨識方的子集,或健保碼差距 2 位內視為同一項)。
|完全未配對|
剩下的才是真正找不到對應的。
價值在於:辨識「誤差」不再被誤判成資料「錯誤」
每一個容錯閾值都可動態調整,依據來自逐張標注的錯誤紀錄:AI 實際怎麼錯、到什麼程度,閾值就依循規律設置。
5 把處理權還給使用者
比對版面幾乎等同辨識詳情頁,差別在下方顯示與之配對的比對資料。不吻合欄位加底色標注,旁顯示比對值,滑過出現操作按鈕可:套用、忽略,或先放著。
不擅自替使用者決定哪一邊才對,因兩邊都可能有誤。
用「確認」機制,人工檢查後放行,即使不吻合也能強取代為吻合。
配對錯了也能恢復:解除配對後,兩筆各自回到未配對狀態,使用者可搜尋並人工重新配對。
列表改用 toggle,不用開抽屜。 比對的節奏是快速掃過幾百筆並在其中切換,抽屜每次開關都是一次中斷,寬度也會被壓窄。讓容器可以依據不同使用情境彈性調整
迭代防呆:AI 若發現新上傳的處方箋與既有資料高度相似,會標示「可能重複」。
包含編輯狀態的細節規範:必填與非必填的差別處理、手動清空後失焦還原原值、未儲存離開的處置、欄位寬度與顯示碼數、阻擋機制與錯誤狀態。
Delivery
已上線並交付單一大型連鎖藥局,實際使用超過一個月。
比對流程:
選定辨識資料或整批 → 上傳藥師系統匯出的比對檔 → 系統檢查格式與再確認 → 執行比對(十秒內完成)。
匯出提供兩種格式:一種與藥師系統相同,逗號分隔的純文字用於回寫;另一種是整齊的 CSV,供人工查看。
辨識正確率的攻堅:AI 一開始的正確率遠低於可用水準。身兼 PM 與測試,逐張標注錯誤位置、分類錯誤型態、整理成報告給工程師,再回頭複測,如此往復來回 6次以上。
這段工作量遠超預期,但需要依此來找出錯誤規律,也是容錯閾值的設定依據。
Result
藥局回報處理確實快很多。但一次上傳 200 多張,辨識等待時間偏長,而系統不會通知什麼時候好。他們會先去做別的事,但不確定什麼時候回來檢查。
他們發展出一套流程:關店前上傳,電腦放著跑,隔天開店再來看結果。
我設計了辨識的準確與可編輯,卻沒有設計等待與完成通知。
若能繼續迭代,方向為:處理進度與預估完成時間(但這確定只能做假象,AI pipeline無法顯示進度條)、完成後的主動通知(串接LINE)、以及明確告訴使用者接續可進行/不可進行的操作(如不能關機、登出等)
相同系統內催生相異解方
下列憑證辨識與處方箋比對的邏輯差異:
憑證報銷 | 處方箋比對 | |
|---|---|---|
文件格式 | 單據多樣性遠超出範本 | 二十餘種但收斂且明確 |
欄位 | 可自訂、命名、排序 | 明確因此系統寫死 |
篩選 | 依欄位型別動態生成 | 固定選項 + 快捷頁籤 |
資料視圖 | 至多六張自訂表格模板 | 單一視圖 |
詳情容器 | 抽屜檢視 | 全寬 toggle 快速收合 |
AI 角色 | 辨識 + 判斷合規 | 只辨識,比對為純運算 |
匯出 | 每個客戶一份對映設定 | 暫定兩種固定格式 |
設計目標 | 一套系統通用到所有需求 | 一種文件辨識能足夠準 |
因情境的歧異度不同,有不同的彈性程度。
彈性同時是價實也是成本,開放自訂的代價包含開發時間成本、使用者的學習負擔、以及系統的複雜度。當情境的歧異度高到寫死就會不斷重工,這個成本就值得承擔到期成為價值;當情境非常明確收斂,彈性就成沒有多少價值的成本,還會讓使用者面對他其實不需要的設定。
Reflections
客戶回饋之服務亮點:
1 發票辨識結果快速清楚
2 bounding box(hover辨識後資料,highlight紙本預覽該處資料範圍)
3 審核規則有成功應用時
4 無硬體限制、費用便宜、操作簡單
本階段問題:
1 實際上的單據變化遠大於持有範本,因此驗收期間通的辨識結果常被挑戰
2 產品不大,但實際導入的門檻似乎比客戶想像的高(人力訓練),常卡在要串接客戶既有系統時有瓶頸,造成業務推進力降低。
3 現階段無法解決(=未來方向):
「切傳票」與「會計帳」整理的麻煩,期望在未來能被解決、串接成一站式會計簽核解決服務。
市場定位問題
中小型企業比較需要這樣的可替代大型ERP之服務,但因紙本量體不大(一千以內/天),使用下來體感沒有省下太多時間,人工做順手後差距確實不太大。
反而是量體大的大公司,就回饋節省很多時間。然大公司通常有長期使用的大型ERP,制度上難以取代。(切入點變成:較新或未成熟專案比較有機會可以帶入)
未來
使用者體驗的亮點已顯示能高度增加客戶興趣,但是效果有限。
問題還是痛點不夠重、導入依舊有門檻在、產品無法全面包覆/替代客戶的整體會計痛點。
可評估回頭繼續完成模組化支線,能滿足高度客製化與變化的需求
對帳:處方箋的資料對比功能已可滿足會計對帳需求,僅需處理移植
有趣回饋
使用體驗做得太順暢容易,在Demo時反而會讓客戶覺得太簡單而沒有亮點。
可考慮加入一點視覺吸引元素(如辨識中的動畫,提升技術實感、給予ah ha moment),顯示UI與視覺設計依然有其價值,(甚至在前期提案即展現)